中國開源 LLM(大型語言模型)的發展,正為AI產業帶來新的商業合作機會。各大LLM模型系列逐步建立開發者生態,企業可以根據業務需要,選擇合適的模型。本文將比較主要中國開源大模型的特點、企業採用開源與閉源模型(Closed-source model)的考量,探討中國開源大模型合作、跨境商業化、科技投資所帶來的發展機遇。
中國開源 LLM 大模型趨勢:技術表現、開發者生態與全球局勢
中國 AI 大模型的發展趨勢正迅速由通用基礎模型邁向至垂直行業的深度應用,並在多模態技術、長文本處理及激烈的 API 價格競爭中持續改善,同時積極建構基於國產晶片的自主運算生態。
中國開源大模型的技術表現
史丹福大學《2026 AI Index Report》指出,全球領先模型在 LMSYS Chatbot Arena 等平台上的表現差距持續收窄,多個地區的模型自 2025 年初多次交替領先。截至 2026 年 3 月,美國最佳模型只領先約 2.7%。排名第 1 與第 10 位的模型差異,由 2023 年的 11.9% 收窄至 2025 年初的 5.4%;在部分主要基準上,開放權重模型與閉源模型的差距則由 2024 年 1 月的約 8% 收窄至 2025 年 2 月的 1.7%,反映開源模型整體能力正快速提升。
在2026年世界互聯網大會烏鎮峰會上發佈的資料顯示,中國開源大模型全球累計下載量已超過100億次,國家級AI開源社區聚集了逾1100萬用戶。阿里巴巴旗下開源社區「魔搭」已吸引全球 239 個國家和地區、3,300 萬名用戶,在此規模下,全球開發者可以調用約 28 萬個開源模型、4 萬個資料集和 1.2 萬個 MCP(模型上下文協議),反映中國的整體開源模型能力正受世界關注,可供選擇的模型亦非常多元。
除了整體模型能力,AI 在實際編程任務中的表現亦值得關注。由 The Product Compass 作者 Pawel Huryn 開展的 Bug Hunt Bench以兩個軟件項目的程式碼庫及預設錯誤,測試模型配合編程代理工具修復錯誤的表現。下圖為 2026 年 10 月 19 日的特定程式碼庫與預設錯誤修復的測試結果:
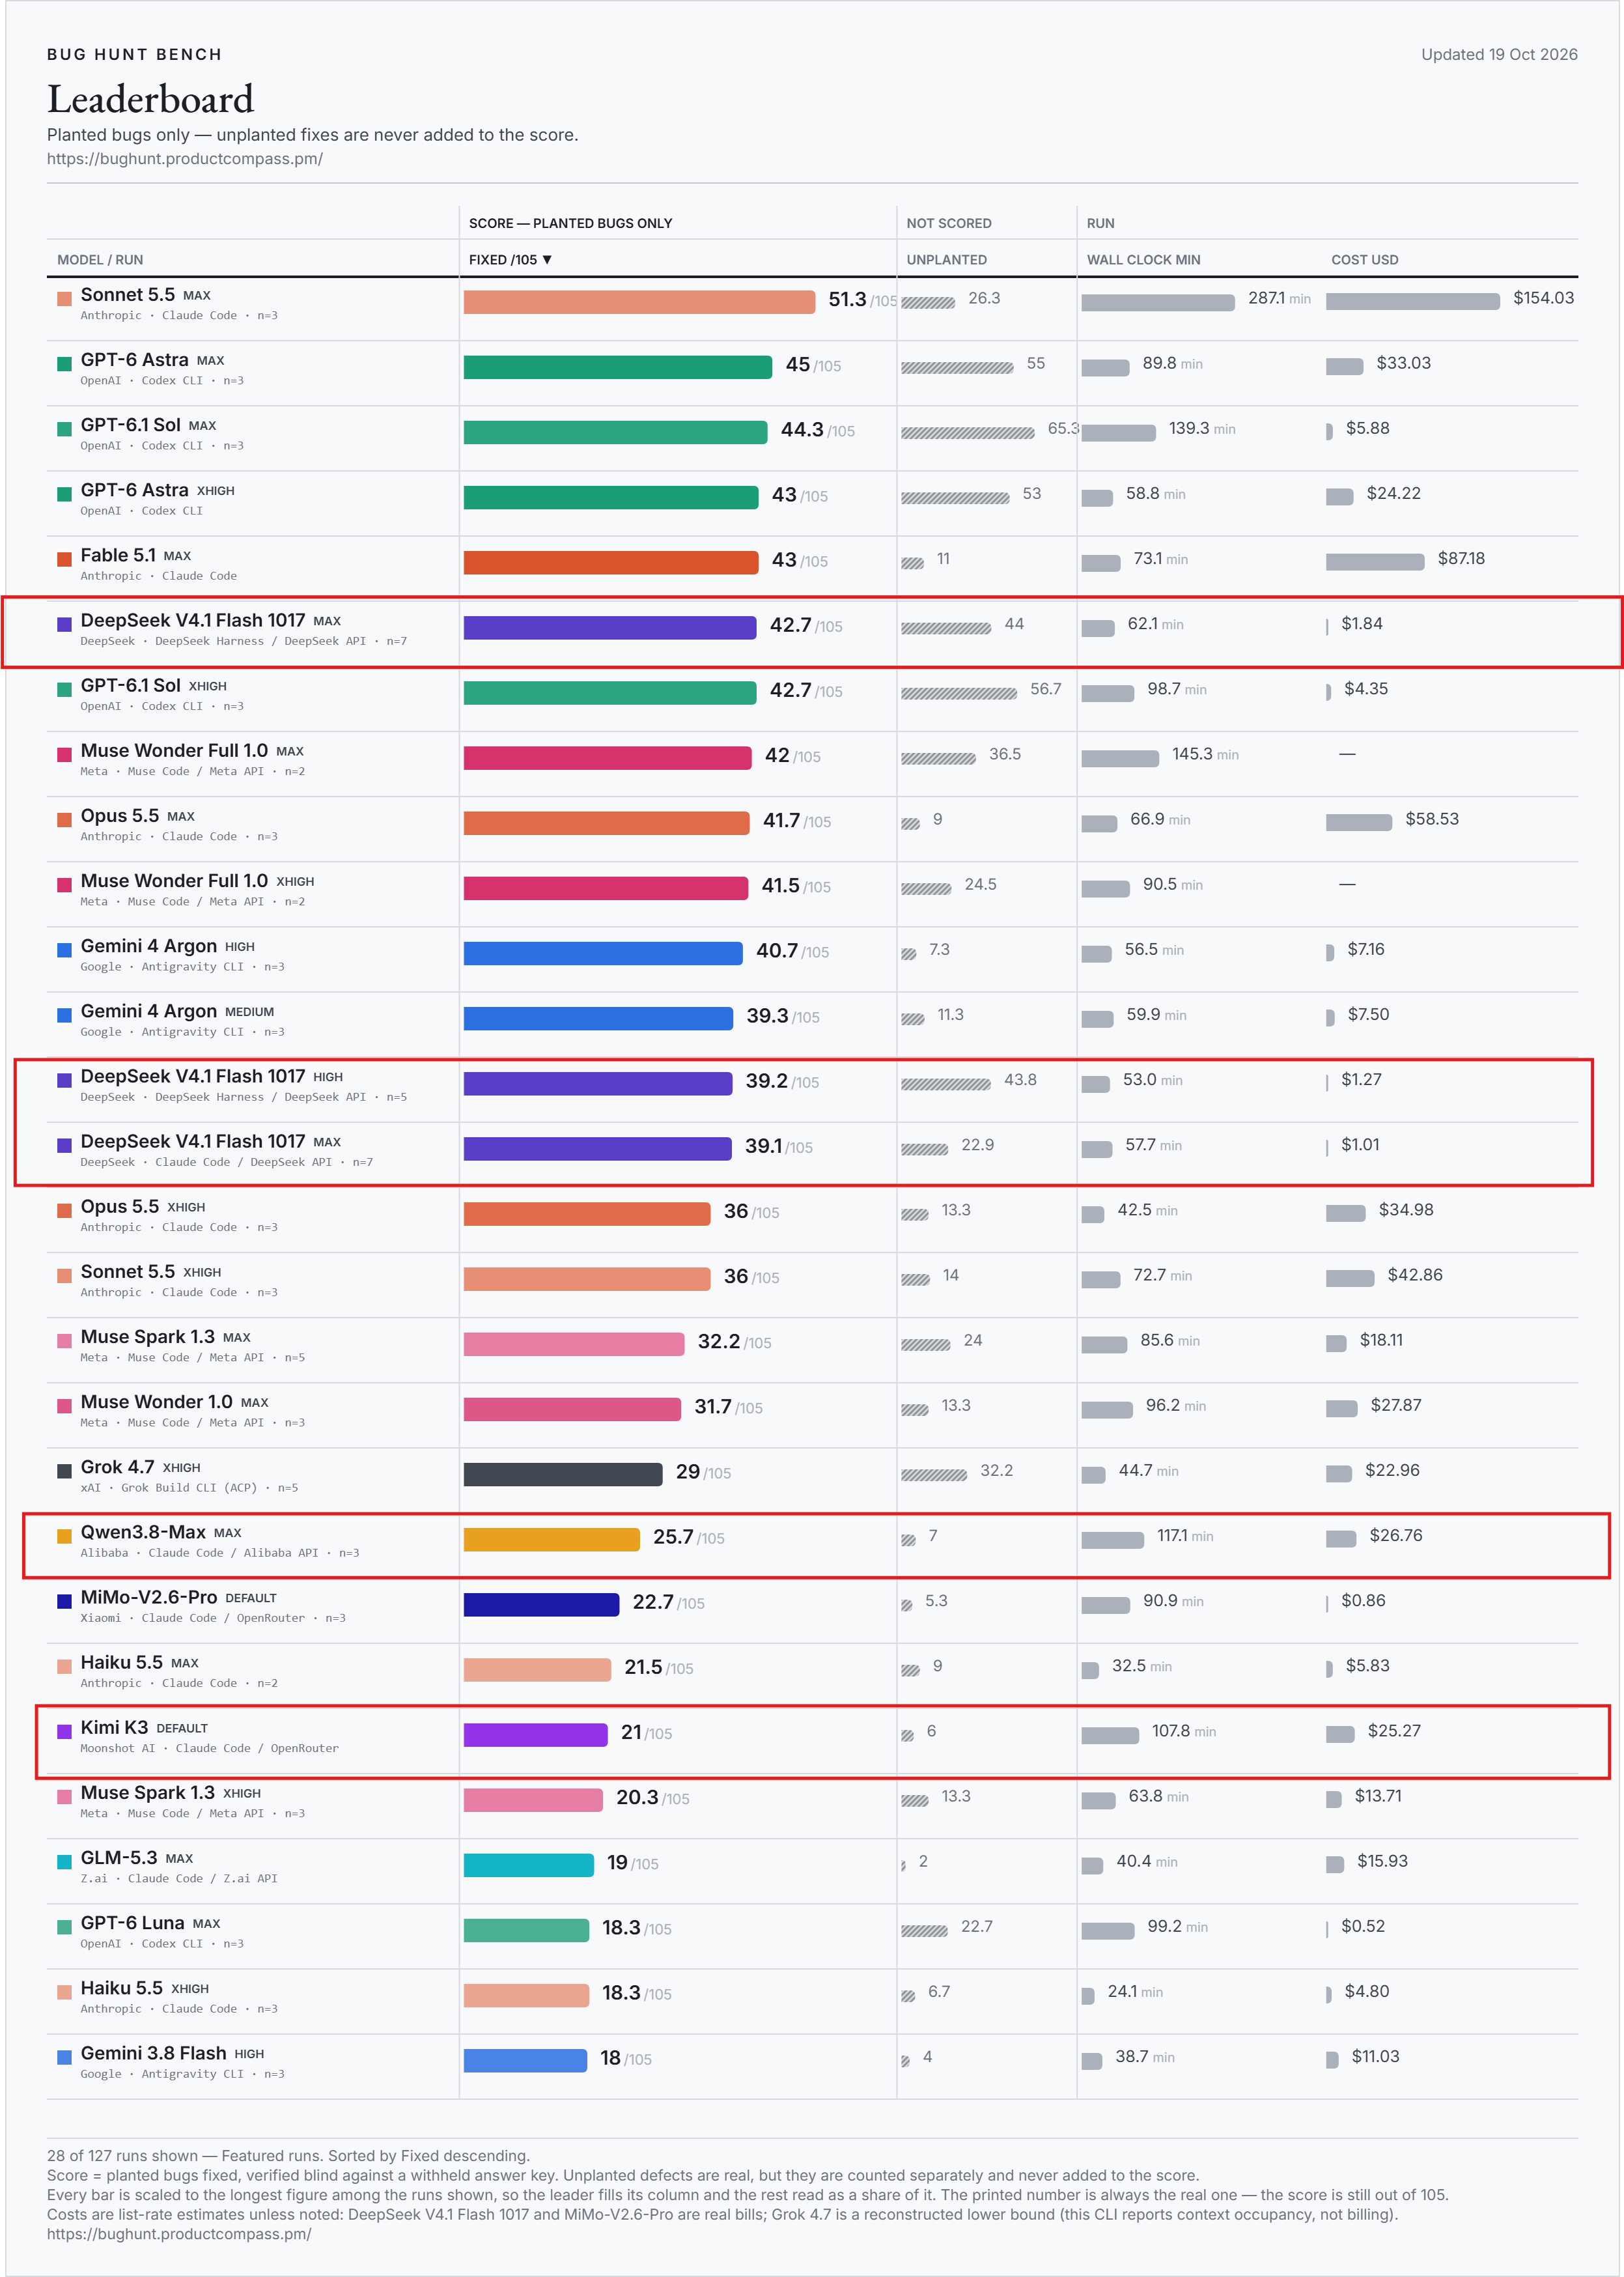
其中,DeepSeek V4.1 Flash 1017 在配合 DeepSeek Harness(經 DeepSeek API 運行)、採用 max 配置的 7 次測試中,平均修復 42.7 個預設錯誤(共 105 個),表現接近部分國際領先模型,但單次測試成本卻遠低於其他各模型,僅約 1.84 美元。不過,要留意以上測試結果是在特定模型版本、DeepSeek Harness 及 max 配置下得出,並非通用於所有企業應用環境的普遍性能指標。此外,由於企業真實生產環境中的網絡架構、通訊延遲、快取策略與供應商折扣各有不同,公開估算成本與實際帳單存在差異,企業應以自身業務場景的工作負載進行綜合 TCO 評估。
綜合兩項研究,中國 AI 模型在國際競爭中的技術實力正受到更多關注,企業 AI 模型選擇方面也因此有更多具競爭力的方案可供考慮,但仍應按自身工作負載進行測試再作決定。
中國開源生態圈與全球開發者社區
中國開源生態圈正加速與全球開發者社區接軌,不僅從過往的技術使用者躍升為核心貢獻者,更同步發展出成熟的本地開源平台以提升技術自主性與國際影響力。開源模型的價值既來自模型本身,也取決於其開發者社群與應用生態。
GitHub 作為全球 LLM 開源協作的核心樞紐,也是中國開源大模型接軌全球的主陣地: Qwen(通義千問)、DeepSeek、Yi(零一萬物)等主流項目均將核心代碼、模型權重、官方工具鏈同步開放於 GitHub,吸引全球開發者貢獻與反饋,深度融入全球開源協作網絡。
配合 Hugging Face 的模型分發體系、ModelScope 的本土化生態聚合,以及中國開發者在推理引擎、微調框架、Agent 工具等上下游領域的持續輸出,整個生態已形成「模型開放-工具共建-場景落地」的正向循環。對企業而言,成熟的開源生態大幅降低 AI 部署與定製化的技術門檻,既豐富了模型的選擇,也讓初創團隊可減少重複基礎研發,專注於業務創新。
企業應如何選擇?開源與閉源中國大模型差異
開源中國大模型容許企業下載模型權重作本地部署與深度微調,數據控制權相對較高,而閉源大模型則隱藏核心技術並僅透過 API 提供雲端服務,企業須依賴供應商的資料處理條款。兩者的私隱保障程度,最終取決於部署架構和合約安排。兩者在長期營運自主權、數據控制權、系統架構及成本預算上都存在重大差異。業界常說的「開源模型」,多數是指開放權重模型(Open-weight Models)。這類模型通常允許使用者取得模型參數並自行部署。閉源模型則不對外公開模型權重、程式碼、訓練細節,使用者僅能透過 API 介接、訂閱服務來調用,所有運作邏輯與模型升級均由供應商掌控,更有利保障企業私隱。 以下一表比較兩者的特點:
開源與閉源大模型差異比較表 | ||
|---|---|---|
比較維度 | 開源模型 | 閉源模型 |
數據私隱與控制權 | 可選擇本地或私有環境部署,控制程度取決於架構 | 通常透過供應商服務處理,須評估資料處理條款 |
模型調整靈活性 | 視授權及模型架構,可進行微調或其他調整 | 通常受限於供應商提供的功能 |
長期總擁有成本(TCO) | 涉及硬件、託管、維護及技術人員成本 | 通常涉及 API 用量、服務訂閱、企業合約費用 |
營運自主權 | 自行管理模型版本及部署環境,但須承擔維護責任 | 供應商負責較多基礎設施工作,但版本及服務政策受供應商影響 |
供應商依賴 | 有機會降低單一服務供應商的依賴 | 可能較依賴特定 API、服務平台及合約安排 |
商用授權 | 須遵守平台服務條款及企業合約 | 須遵守平台服務條款及企業合約 |
無論開源或閉源模型,都可透過 API 服務快速部署及落地應用,免除初期基礎設施投入,適合企業快速開展概念驗證。但是,閉源模型僅能依賴廠商 API 和訂閱情況,長期成本完全受制於使用量與供應商定價;而開源模型在 API 之外還額外具備本地私有化部署的選項。
企業自行部署 LLM,需要承擔 GPU、維護、安全與技術團隊等成本。當用量較大且穩定時,自建方案可能具成本優勢;實際總擁有成本仍取決於硬件使用率、模型更新、人力、服務水平及託管條款,應與 API 報價按同一工作使用量進行比較。
主流中國開源大模型盤點與綜合評估
中文開源語言模型有哪些?目前值得企業關注的中國開源大模型包括 DeepSeek、Qwen(通義千問)、Yi(零一萬物)、智譜 GLM 等。它們在模型設計、推理能力、開發工具、商業應用方向上各有特點。
模型系列 | 研發實體 | 核心優勢領域 | 語境理解能力表現 | 適合應用場景 |
DeepSeek-R1(代表版本) | 深度求索(DeepSeek AI) | 以推理與數學任務為主要評估方向;上下文長度、部署需求及成本須按具體版本核對 | 中文及專業語境表現應以企業自有測試集驗證,特別是術語、長文本及事實準確度 | 可測試編程輔助、知識問答與推理任務;敏感資料場景另需安全及部署評估 |
Qwen3-235B-A22B(代表版本) | 阿里巴巴雲智能事業群 | 可評估多語言理解、推理與工具使用;多模態及上下文規格因具體版本而異 | 應測試繁體中文、香港用語及行業術語;不以單一中文排行榜推斷所有版本的能力 | 可測試企業知識庫、客服及文件處理;多模態用途需另選相應版本 |
Yi-1.5-34B-Chat(代表版本) | 北京零一萬物科技有限公司 | 可評估中英文對話及長文本處理;上下文規格與輸出質素須核對模型卡和實測 | 專業文件擷取和寫作質素需以代表性資料測試,並設人工覆核 | 可測試文件摘要、內容草擬及對話用途;法律等高風險輸出需專業覆核 |
GLM-5(代表版本) | 智譜 AI(北京智譜華章科技有限公司) | 可評估編程輔助、工具調用及代理任務;排行榜名次隨日期和設定變動 | 專業術語、指令遵循及事實準確度須以業務測試集驗證 | 可測試知識管理、軟件研發和數據分析輔助;需評估權限及人工覆核 |
比較以 DeepSeek-R1、Qwen3-235B-A22B、Yi-1.5-34B-Chat 和 GLM-5 的官方模型卡為參考,屬待驗證的選型方向,並非即時性能排名。請在採用前核對版本、授權、測試日期及企業自身工作負載。模型卡:DeepSeek-R1|Qwen3|Yi-1.5|GLM-5。
中國開源大模型授權怎麼看?商用條款與企業注意事項
企業在採用中國開源大模型前,應先確認具體版本的商用授權條款。目前主流模型多以開放權重形式發布,常見授權包括 MIT License 及 Apache 2.0。這類許可證一般允許商業使用、修改及再分發,但仍須保留原授權聲明,且不同版本可能附帶額外限制。以 DeepSeek 系列(如 DeepSeek-R1)為例,其官方模型卡及公告明確表示,程式碼與模型權重均採用 MIT License,允許商業使用、修改及衍生作品(包括蒸餾)。不過,不論使用哪一款開源大模型,企業都應在正式採用前檢查以下事項:
核對官方文件:下載並仔細閱讀該版本官方模型卡與 授權條款文件,確認實際適用的許可證類型(如 MIT 或 Apache 2.0),避免僅依賴第三方摘要。
確認商用與衍生權限:明確核實是否允許商業使用、微調、再分發及衍生作品,並留意是否有任何使用限制或附加條件。
檢查門檻與附加條款:留意是否設有營收門檻、月活躍用戶限制、地域限制或其他特殊條款,尤其是較大型號或特定版本可能採用自訂授權。
建立授權管理機制:保留完整授權聲明與模型卡紀錄,並建立內部授權管理流程,以便在模型升級或擴展使用範圍時能迅速重新審核。
不同條款可能會隨版本更新而調整,建議企業在每次升級模型時重新審核,避免因授權不符而影響商業使用。
企業級託管與模型開放平台的技術架構及算力需求
中國開源大模型能否順利投入企業使用,取決於模型能力與基礎設施之間的配合。企業通常可以考慮透過 API 使用雲端模型服務,或自行部署開放權重模型。
託管與 API 平台:阿里雲百煉等服務可協助企業進行模型調用與原型驗證;ModelScope 主要提供模型與開發者資源,百度飛槳則屬深度學習框架。各平台功能、資料處理條款與價格不同,選用前須分別核對。
硬體與算力配置預算:記憶體與 GPU 需求取決於模型版本、量化精度、上下文長度、並發量及微調方式。企業應以所選模型的官方部署文件和實際負載測試估算設備與營運成本,避免以單一參數規模推定固定顯存需求。
混合雲部署策略:1–7B 級輕量化模型(SLM)可部署於邊緣伺服器、終端設備等 Edge AI 節點,實現敏感數據本地處理、低延時響應;複雜推理與長鏈路任務則調用雲端大模型,形成「邊緣輕量處理 + 雲端深度計算」分層架構,兼顧數據合規與運算效率。
中國開源大模型跨境出海的企業級數據安全與合規治理
中國開源大模型的企業級數據治理(Data Governance),是跨境商業化不可忽視的環節。即使企業可以自行部署模型,也不代表系統自然符合所有數據私隱及資訊安全要求。合規程度取決於實際部署方式、資料流向、供應商安排以及營運所在地的適用法律。
數據隔離與私有化部署:本地機房、私有雲或虛擬私有雲(VPC)可提供不同程度的環境控制。企業仍須審核外部 API、日誌、監控和第三方服務的資料流向,確認是否存在資料留存、回傳或二次訓練安排。
符合國際隱私法規:遵循通用企業級數據保護標準工程實踐,針對歐盟《一般資料保障規例》(GDPR)等全球主流隱私與數據保護框架,基於部署架構落地對應合規要求:涉及跨境個人資料傳輸時,可採用歐盟委員會發布的標準合同條款(SCC)、充分性認定等合規傳輸機制開展評估與落地;在不同營運區域均按當地適用的數據保護法規完成架構適配,確保數據處理活動全鏈路符合規範。
安全護欄與權限控管:企業可從三方面建立防護:輸入/輸出內容過濾,降低敏感數據外洩、不當內容生成及 LLM 幻覺帶來的事實風險;機密計算(Confidential Computing),利用硬件層面的可信執行環境(TEE)保護推理過程中的數據;角色存取控制(RBAC),按職責劃分模型、數據與系統功能的存取權限,並保留操作紀錄以便審計。
從開發者工具走向企業應用:跨越 PoC 階段的商業化路徑。
以下四個階段可作為企業評估中國開源大模型合作與商業化的參考。
1. 基礎模型選型與業務調整
企業首先需要確定 AI 應用的商業目標,例如改善文件處理效率、支援客戶服務、協助技術團隊完成特定任務。
其後可根據需求選擇模型,並考慮通過以下技術微調:
檢索增強生成(RAG): 在回應查詢時檢索企業知識庫內容,為模型提供額外的參考資訊,通常毋須修改模型權重。
LoRA 等微調方法: 透過額外訓練調整模型的部分參數,使模型更適合特定任務。
2. 真實環境概念驗證
在小規模測試階段,企業需要確認模型能否解決具體業務問題。
測試可以使用經適當授權、數據清洗、去識別化敏感業務資料,設定準確度、處理時間、成本、使用者體驗等關鍵績效指標(KPI)。
同時,企業應收集使用者及業務部門的意見,確認 AI 功能是否符合實際工作流程。
3. 營運合規與風險評估
當 AI 方案進入正式營運前,企業須完成資訊安全、商用授權、適用法規的評估。
相關工作包括跨境資料處理審查、系統壓力測試、存取權限管理,故障與業務持續性安排。
如果模型需要接入外部系統,亦應評估第三方服務中斷或模型更新對業務運作的影響。
4. 規模化部署與生態合作
概念驗證成功後,企業可以逐步將 AI 應用整合至更多業務流程,評估其長期商業價值。
對於佈局跨境市場的科技初創企業,此階段需同步完成目標市場需求適配、本地化技術支援體系、渠道合作網絡、客戶採用路徑等多維度評估。透過與當地成熟產業夥伴開展生態合作,可快速切入多元應用場景、補齊本地化運營資源短板;最終將驗證成熟的標準化解決方案複製推廣至完整產業生態圈,實現從技術落地到規模化商業變現的完整閉環。
支持科技初創:MTR Lab 企業創投與跨境創新網絡的戰略價值
中國開源大模型的發展為 AI 初創企業提供更多技術選擇;要轉化為可驗證的商業價值,仍需處理產品需求、場景測試及市場拓展等問題。
MTR Lab 是專注投資創新科技的戰略企業創投(Corporate Venture Capital,CVC)平台,更是連接內地科技領袖、自身投資組合企業(portfolio companies)與香港及全球市場的核心樞紐。
MTR Lab持續擴展其全球創科投資組合 ,並沿 AI 價值鏈佈局,涵蓋基礎模型與底層技術、AI 基礎設施,以及涵蓋網絡安全的企業級解決方案。2025 年於全球接獲的潛在投資項目中,AI 及機械人相關提案較 2024 年增長近兩倍,其中來自中國內地的項目佔比超過三成。對於具備成熟產品、市場潛力與擴展能力的初創企業,MTR Lab 可按個別項目透過投資與合作網絡,探索產業對接、場景驗證及市場拓展機會。
內地頂尖科技生態夥伴——中關村科學城公司(ZGC Science City Ltd.)
2026 年 3 月,MTR Lab 與北京中關村科學城創新發展有限公司(中關村科學城公司)正式建立生態合作夥伴關係。雙方聚焦智慧城市與可持續發展,覆蓋人工智能、機械人、智慧出行、鐵路科技等前沿技術領域,一方面共同挖掘優質科技企業的投資機會,另一方面依托 MTR Lab 的香港樞紐地位與全球商業網絡,支持具潛力的企業及投資組合公司落地香港、開拓海外市場。
中關村科學城所在的北京海淀區匯聚了中國頂尖的科研機構與科技企業,是內地 AI 技術創新的核心源頭。雙方計劃透過創科網絡探索投資、試點應用與跨境拓展機會。這為具潛力的企業提供接觸產業場景和市場資源的途徑,形成一個具有一定規模的、貫穿專案孵化-專案投資-投後加速的良性生態閉環。
內地頂尖科技生態夥伴——啟迪之星(TusStar)
除中關村科學城公司外,MTR Lab 亦與內地首批國家級創科孵化器啟迪之星達成戰略合作,進一步豐富跨境創新網絡的資源厚度。2025 年 5 月雙方正式建立合作夥伴關係,聚焦智慧城市與可持續發展領域,計劃透過資源共享、項目互薦、產業夥伴對接等方式,共同探索業務合作、潛在投資與國際市場拓展機會。
啟迪之星擁有覆蓋內地及全球的創科網絡,能為初創企業導入多元產業資源;MTR Lab 則結合自身科技投資經驗、香港本地商業網絡與多元產業場景優勢,為雙方篩選出的優質 AI 企業提供技術落地的驗證場景與商業化支撐。
對發展企業級 AI 應用的初創企業而言,這類跨境合作模式既有利於提升技術能力,也有利於建立可靠的產業夥伴關係,驗證市場需求,促進規模化發展。
結論與建議
中國開源 LLM 正為企業提供更多人工智能技術選擇,也為中國內地科技企業參與全球創科生態創造新的機遇。但對企業而言,模型性能與開放程度只是 AI 落地的起點,要真正將技術優勢轉化為可持續的商業護城河,仍需跨越三大核心挑戰:建立符合全球標準的數據合規體系、搭建成熟的企業級技術治理架構、找到經真實市場驗證的商業應用場景。
對於有意順應中國開源大模型趨勢持續發展、佈局跨境市場,或推動開源 AI 解決方案商業化的初創企業與科技決策者而言,產業資源、投資網絡與場景驗證平台是加速落地的關鍵支撐。MTR Lab 持續透過科技投資及策略夥伴關係,連繫不同市場的創科資源,探索有助推動智慧城市與可持續發展的創新方案,可為企業提供從資本投入、場景驗證到市場拓展的全鏈路支持。具備成熟產品、業務發展潛力及相關產業應用方向的科技企業,可透過 MTR Lab 分享創新方案,探索潛在投資與中國開源大模型合作機會。
常見問題(FAQ)
企業使用中國開源大模型(如 Qwen 或 DeepSeek)進行商業化時,需要注意什麼?
企業首先需要核對具體模型版本的商用授權,包括模型修改、再分發及衍生作品的相關條款。其次,應評估模型準確度、部署成本、數據私隱及資訊安全要求。即使模型允許商業使用,企業仍須遵守適用的個人資料保護及其他法規。
企業應如何建構中國開源 LLM 的私有化部署,以符合國際數據私隱要求?
企業可按實際需要評估本地部署、私有雲或虛擬私有雲(VPC),並建立數據分類、加密、存取控制及日誌管理機制。同時,須檢查外部 API、供應商資料處理政策及跨境資料傳輸安排。私有化部署可以增加部分數據控制能力,但不能單獨保證符合法規要求。
MTR Lab 能為開發開源 AI 應用的初創企業提供哪些超越資金的戰略支持?
MTR Lab 主要透過連接相關業務場景機會作技術測試、策略指導及豐富的產業網絡連繫來全方位扶持初創企業。除了潛在的資本投資外,MTR Lab 更著重協助企業將技術落地及拓展市場;至於最終的實際合作安排與資源投入力度,則會因應初創企業的技術成熟度、具體業務需求,以及與 MTR Lab 投資方向的協同效應來作個別的深入評估。
